Support
\ この記事が役に立ったと思ったら、サポートお願いします! /

Share
関連記事
Prophetで時系列データ予測
2021.06.27
機械学習で使われる評価関数まとめ
2021.05.19
【入門強化学習】とりあえず動かしてみる強化学習
2021.05.18
NeuralProphetで時系列データ予測
2021.07.25
\ この記事が役に立ったと思ったら、サポートお願いします! /
こちらの記事はQiitaで投稿した「実装して理解する人工知能・機械学習・ディープラーニング」の再投稿になります。
AI(人工知能)が流行っていますが、人工知能・機械学習・ディープラーニングがそれぞれどんなものなのか、実際に動かしながら理解していきます。 ただし、どんなものかを実感するだけなので、ゼロから実装するのではなくライブラリ・フレームワークを活用します。
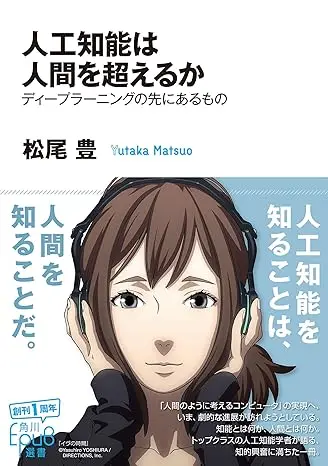
そもそも人工知能とは何なのかについて考えます。 「人工知能は人間を超えるか」では、以下のように説明されています。
本当の意味での人工知能 -つまり、「人間のように考えるコンピュータ」はできていないのだ。
つまり、今は人間のような活動をしているようにみえる技術を総じて人工知能と呼んでいることになります。 さらには、人工知能自体の定義も専門家の間で定まっていません。
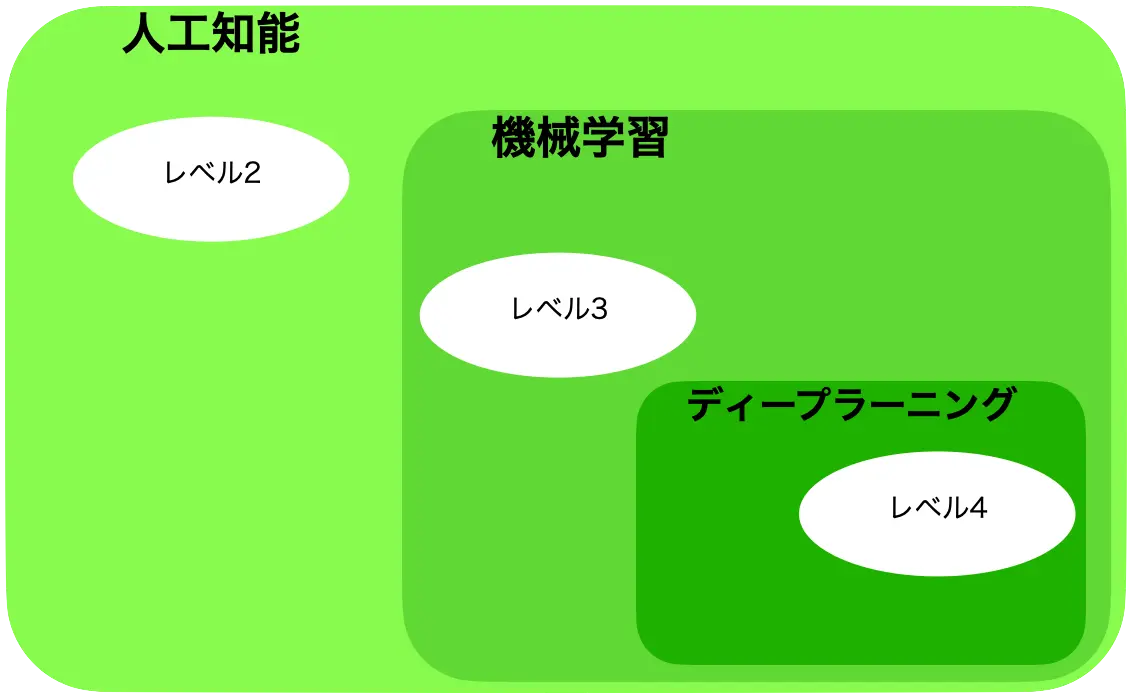
世の中で人工知能と呼ばれる物は4つのレベルに分けることができると「人工知能は人間を超えるか」では言われています。
レベル1:単純な制御プログラム(制御工学)
レベル2:古典的な人工知能
レベル3:機械学習
レベル4:ディープラーニング
人工知能・機械学習・ディープラーニングはそれぞれ以下のようになります。
人工知能・機械学習・ディープラーニングとレベル別の人工知能の関係は図の通りになります。
実際に動かしてみましょう。実装するのは、レベル2・レベル3・レベル4の人工知能になります。 それぞれのレベルにて、正答率(0.0 ~ 1.0)をスコアとして計算しています。
まずは、人工知能が予測するデータについて説明します。 scikit-learnのアヤメのデータセットを利用します。
人工知能は、インプットされたデータ(特徴量)から結果を予測します。今回は、予測するアヤメは3品種あり、どのアヤメかを予測します。 予測するための特徴量は以下の通りです。
データの中身を少し見てみます。最後のtarget列がアヤメの名前になります。
1   sepal length (cm)  sepal width (cm)  petal length (cm)  petal width (cm)  target
20                5.1               3.5                1.4               0.2  setosa
31                4.9               3.0                1.4               0.2  setosa
42                4.7               3.2                1.3               0.2  setosa
53                4.6               3.1                1.5               0.2  setosa
64                5.0               3.6                1.4               0.2  setosa
75                5.4               3.9                1.7               0.4  setosa
86                4.6               3.4                1.4               0.3  setosa
97                5.0               3.4                1.5               0.2  setosa
108                4.4               2.9                1.4               0.2  setosa
119 4.9 3.1 1.5 0.1 setosaまずは古典的な人工知能を実装します。 今回はデータから傾向を見つけ、簡単な知識を入れました。
1from sklearn.datasets import load_iris
2from sklearn.model_selection import train_test_split
3
4# データのインポート
5iris = load_iris()
6
7# 特徴量と目的変数に分ける
8X = iris['data']
9y = iris['target']
10# 学習させるデータと学習したモデルの精度を測るデータに分ける
11# レベル2の実装では自ら学習しないため精度を測るデータのみを利用する
12X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
13
14# 予測するためにルール(知識)を埋め込んだ関数
15# 特徴量の値で分岐して予測する
16def predict_iris(feature):
17    if feature[2] < 2 and feature[3] < 0.6:
18        return 0
19    elif 2 <= feature[2] < 5 and 0.6 <= feature[3] < 1.7:
20        return 1
21    else:
22        return 2
23
24# スコアを計測する関数
25def compute_score(pred, ans):
26    correct_answer_num = 0
27    for p, a in zip(pred, ans):
28        if p == a:
29            correct_answer_num += 1
30    return correct_answer_num / len(pred)
31
32pred = []
33for feature in X_test:
34    pred.append(predict_iris(feature))
35
36score = compute_score(pred, y_test)
37
38print('Score is', score)
結果
1Score is 0.9555555555555556次に機械学習の実装をします。 機械学習は、プログラムがデータから学習します。
今回使うアルゴリズムはロジスティック回帰であり、Pythonの機械学習ライブラリであるscikit-learnを利用します。
1from sklearn.datasets import load_iris
2from sklearn.model_selection import train_test_split
3from sklearn.linear_model import LogisticRegression
4
5# データのインポート
6iris = load_iris()
7
8# 特徴量と目的変数に分ける
9X = iris['data']
10y = iris['target']
11# 学習させるデータと学習したモデルの精度を測るデータに分ける
12X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
13
14# 利用するアルゴリズムをロジスティック回帰とする
15model = LogisticRegression()
16# 学習
17model.fit(X_train, y_train)
18# スコア計測
19score = model.score(X_test, y_test)
20
21print('Score is', score)
結果
1Score is 0.8888888888888888最後にディープラーニングの実装です。 ディープラーニングは、プログラムがデータから特徴量を生成し、学習します。
今回実装するディープラーニングは5層からなるニューラルネットワークになります。使用するライブラリはkerasになります。
1from sklearn.datasets import load_iris
2from sklearn.model_selection import train_test_split
3from keras import layers
4from keras import models
5from keras.utils import np_utils
6
7# データのインポート
8iris = load_iris()
9
10# 特徴量と目的変数に分ける
11X = iris['data']
12y = np_utils.to_categorical(iris['target'])
13# 学習させるデータと学習したモデルの精度を測るデータに分ける
14X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)
15
16# 5層のニューラルネットワークのモデルを定義
17model = models.Sequential()
18model.add(layers.Dense(64, activation='relu'))
19model.add(layers.Dense(64, activation='relu'))
20model.add(layers.Dense(64, activation='relu'))
21model.add(layers.Dense(64, activation='relu'))
22model.add(layers.Dense(3, activation='softmax'))
23model.compile(optimizer='adam', loss='categorical_crossentropy', metrics=['accuracy'])
24
25# 学習
26model.fit(X_train, y_train, epochs=10, batch_size=10)
27
28# スコア計測
29score = model.evaluate(X_test, y_test)
30
31print('Score is', score[1])
結果
1Score is 0.8888888955116272人工知能・機械学習・ディープラーニングは以下のような意味でした。
それぞれのスコアについては、最も単純なルールベースが高いという結果になりました。 ただし、今回はとても単純なデータだったため、機械学習・ディープラーニングの真価が発揮されていないという点に注意してください。
人工知能/AIが最近は話題になっていますが、手段(AIであるかどうか)ではなくて何をしたいか(目的)が大切なのだと感じました。